Pourquoi les benchmarks IA ignorent le travail de bureau quotidien
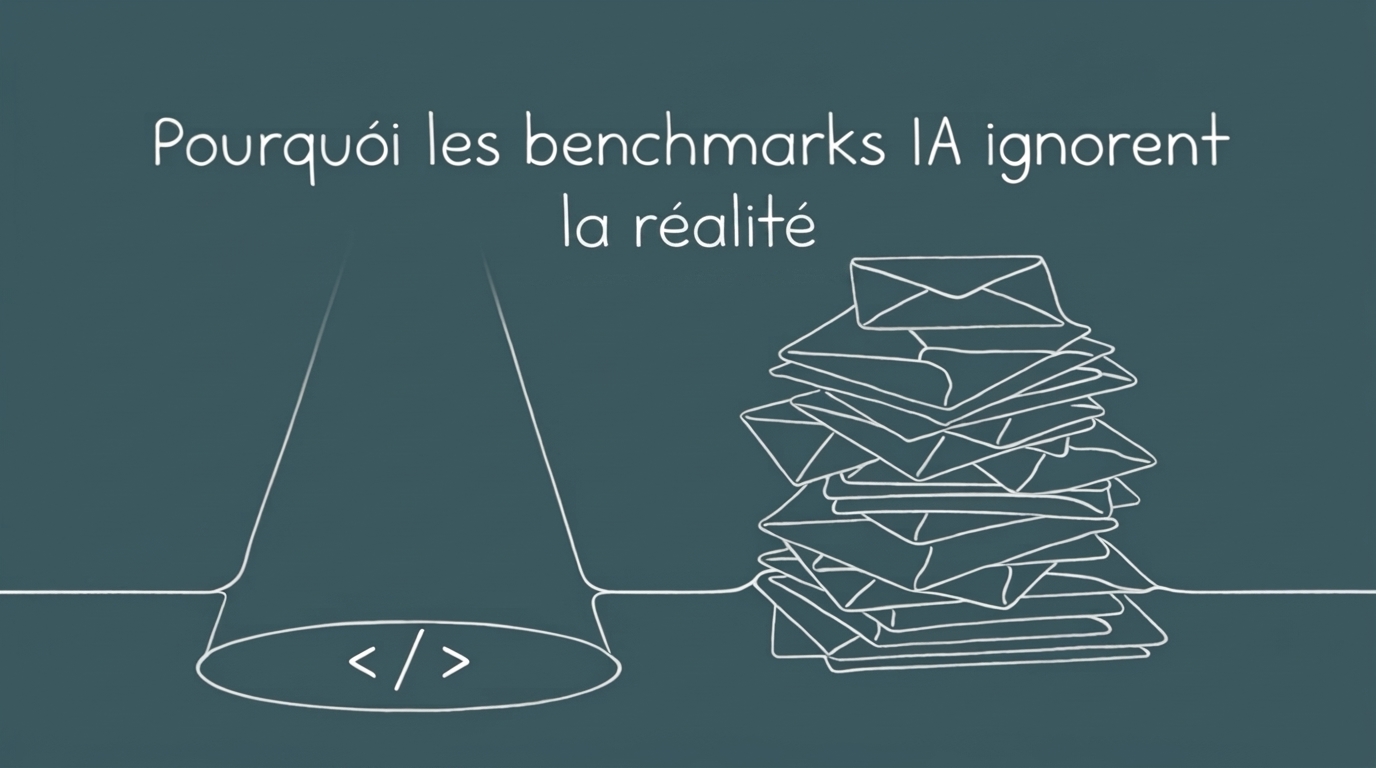
Des classements centrés sur le code
Prenez n'importe quelle publication récente de modèle de langage et regardez la table des évaluations. GLM-5, dernier modèle en date du laboratoire chinois Zhipu AI, en est un exemple typique : ses concepteurs le testent sur SWE-bench Verified, SWE-bench Multilingual, Terminal-Bench 2.0 et CyberGym, quatre bancs d'essai qui mesurent la capacité d'un modèle à résoudre des tickets logiciels, naviguer un terminal ou trouver des failles de sécurité. Les résultats sont mis en avant : GLM-5 atteint l'état de l'art sur les benchmarks de code parmi les LLM open-source, et fait mieux que Gemini 3 Pro sur SWE-bench Verified, tout en dépassant Gemini 3 Pro et GPT-5.2 sur SWE-bench Multilingual.
Ce choix n'est pas propre à GLM. Il traverse toute l'industrie parce que le code a deux qualités rares : il est vérifiable automatiquement (un test passe ou ne passe pas) et son impact financier est facile à raconter. Un modèle qui écrit du code économise des heures d'ingénieur, chiffre immédiatement lisible pour un investisseur.
Ce que les chiffres de McKinsey suggèrent d'autre
Cette focalisation sur le code déforme la perception de ce que l'IA change dans une organisation. Le cabinet McKinsey a chiffré, dans son étude sur le potentiel économique de l'IA générative, que quatre fonctions représentent 75 % de la valeur annuelle totale que la technologie peut générer : marketing et ventes, opérations clients, ingénierie logicielle et R&D. Le code n'est donc qu'une fonction parmi quatre, et les trois autres reposent d'abord sur de l'écrit : rédaction commerciale, réponses clients, notes de synthèse.
Plus révélateur encore, une étude plus ancienne mais toujours citée du McKinsey Global Institute avait mesuré le temps que les travailleurs du savoir consacrent chaque semaine à des tâches purement textuelles et non techniques. Le chiffre retenu : 28 heures par semaine passées par les travailleurs du savoir à écrire des e-mails, chercher de l'information et collaborer en interne. Cette étude date de 2012 et portait sur les outils collaboratifs, mais elle illustre une réalité toujours actuelle : l'essentiel du temps de bureau va à l'écrit du quotidien.
Ce que cela change
Deux conséquences pratiques. D'abord, un modèle excellent sur SWE-bench ne dit rien de sa capacité à rédiger un mémo interne cohérent, synthétiser une réunion ou mettre à jour proprement une base de données textuelle : ces tâches n'ont pas de test binaire "passe / échoue", et sont donc absentes des classements. Ensuite, les benchmarks de code eux-mêmes ne sont pas la mesure neutre qu'on imagine : plusieurs analyses notent que les modèles chinois, entraînés sur des jeux de données proches des benchmarks publics, obtiennent des scores plus modestes sur les versions "décontaminées" conçues pour empêcher le bachotage, ce qui invite à tester sur ses propres cas d'usage plutôt qu'à se fier aux classements affichés.
Ce qu'il faut en retenir
Choisir un modèle sur la seule base de ses scores de code, c'est optimiser pour la fonction la plus visible mais pas nécessairement la plus utile à l'organisation. Avant tout déploiement, l'inventaire utile porte sur les tâches textuelles quotidiennes, aujourd'hui non mesurées, qui consomment le plus de temps. La valeur non captée se trouve là, et elle reste sous-exploitée parce qu'elle est difficile à quantifier.